

产品定位
认识LibTV
LibTV 定位为在线 AI 视频创作服务平台,核心解决用户利用先进扩散模型(特别是 Seedance 2.5)进行低成本、高效率视频素材制作的需求。其边界在于提供云端算力渲染,而非本地部署或后期剪辑编辑。
能力图谱
能帮你完成什么
核心视频生成
基于自然语言描述或静态图像素材,通过底层 AI 模型生成动态视频片段。
- 文本到视频生成
- 输入一段描述性文字 prompt,系统调用 Seeddance 2.5 模型输出对应的动态视频流。
- 图像转视频 (Image-to-Video)
- 上传一张静态背景图或关键帧,利用模型理解画面语义并生成连贯的动作与运镜效果。
模型服务与管理
对特定版本模型(如 Seedance 2.5)进行访问、调度及相关任务监控。
- 高性能模型接入
- 提供经过优化的 Seedance 2.5 模型接口,保障生成过程的响应速度与资源利用率。
- 任务状态追踪
- 用户在提交生成请求后,可实时查看计算进度及结果渲染状态。
基础文本生视频流程
单图动态化改造
选型判断
它适合你吗
值得考虑的情况
- 追求低成本 AI 实验的创作者
- 资料提及该平台拥有极具竞争力的价格优势,适合预算有限但需高频尝试的用户。
- 侧重使用最新开源模型的团队
- 平台深度整合了 Seedance 2.5 版本,能直接体验该模型的性能特点。
需要权衡的地方
- 高度依赖云端算力
- 无法在离线环境下工作,且受限于平台的并发排队情况可能影响交付速度。
- 主要侧重于生成环节
- 不具备复杂的时间线剪辑、多轨道合成等专业视频编辑功能,需配合其他软件使用。
开始之前
- 稳定的网络连接,用于加载云端渲染页面及传输大体积媒体文件。
- 熟悉基础的 Prompt 编写技巧,以获得更可控的输出质量。
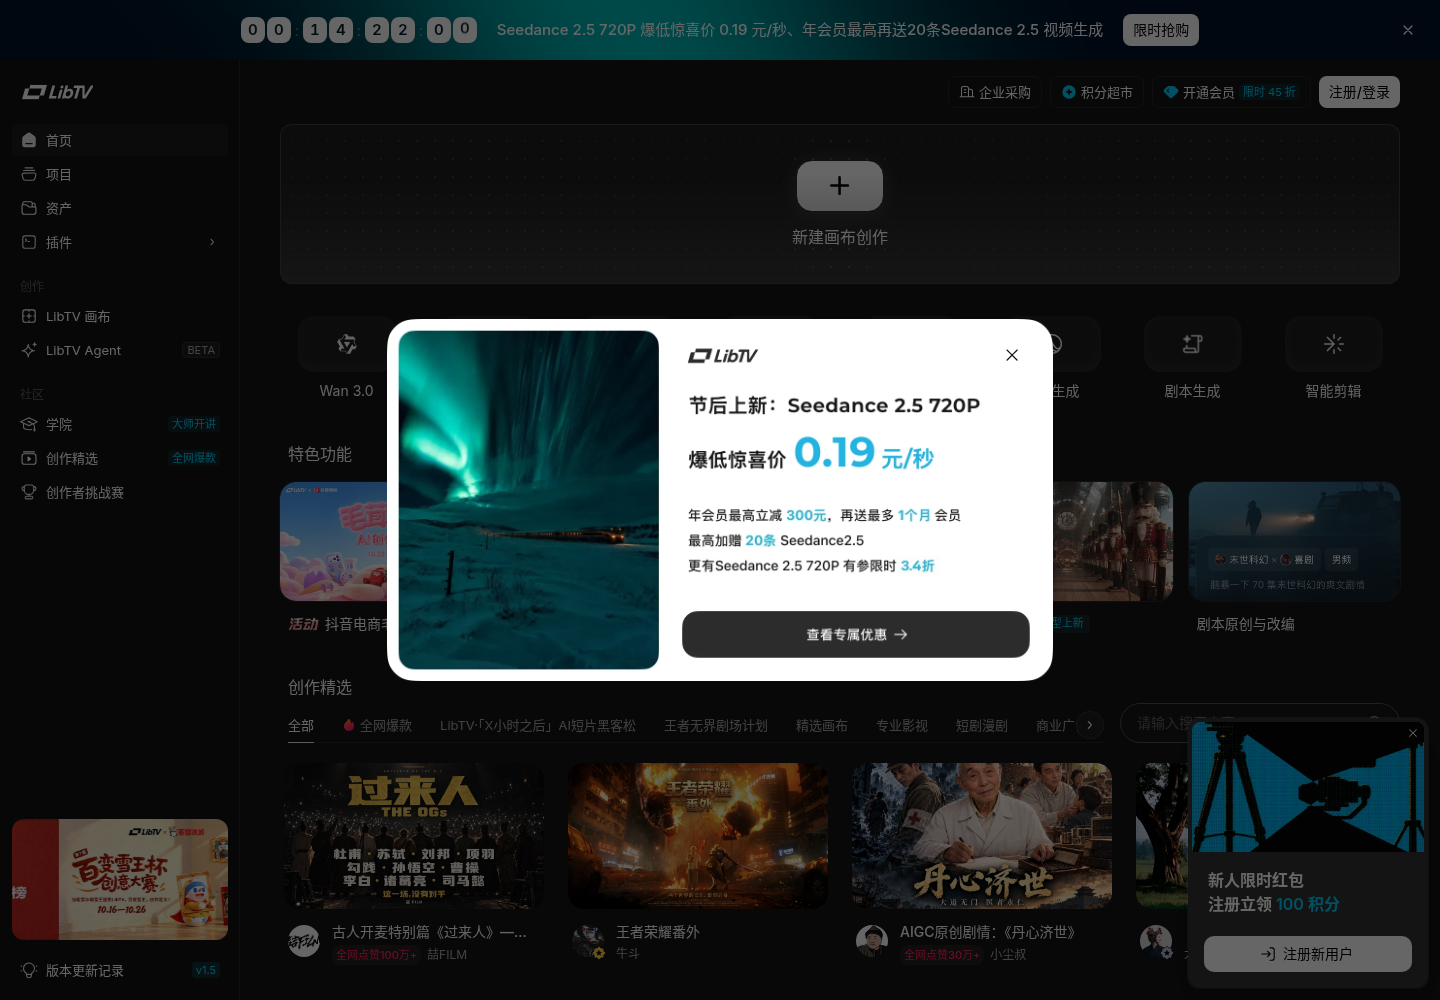
产品界面
看一眼实际界面